社区
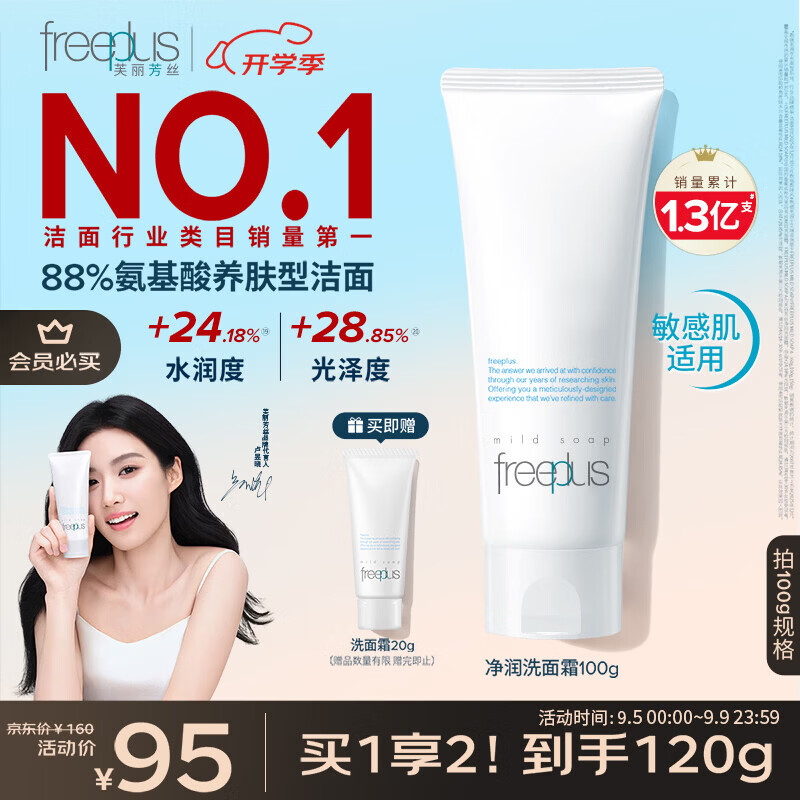
芙丽芳丝(Freeplus)洁面洗面奶霜氨基酸敏感肌男女士通用深层清洁保湿100g


1 / 8
好的,我们来全面、系统地解析一下DeepSeek-R1模型,包括它的特点、原理、优势和局限性。
1. 一句话概括
DeepSeek-R1 是一个由深度求索(DeepSeek)开发的、具备 强大推理能力 的 开源 大型语言模型。它最核心的突破在于,通过 强化学习 技术,让模型自发涌现出“思考”和“自我纠错”的能力,从而在数学、编程、逻辑推理等复杂任务上达到了媲美甚至超越 OpenAI 的 o1 系列模型的效果。
2. 核心特点与创新
我们可以把它的特点分为几个关键维度:
| 特点 | 说明 |
|---|
| <strong>卓越的推理能力</strong> | 这是R1最核心的卖点。它特别擅长处理需要<strong>多步骤逻辑推导</strong>的复杂任务,例如:<br>• <strong>数学竞赛题</strong>:可以完成复杂的代数、几何、微积分证明。<br>• <strong>代码生成与调试</strong>:能根据复杂需求生成代码,并能在执行出错后自我反思和修正。<br>• <strong>科学研究辅助</strong>:能帮助整理思路,进行逻辑严谨的分析。 |
|---|---|
| <strong>“思维链”(Chain-of-Thought,CoT)的显性化</strong> | 当R1面对复杂问题时,它会生成一个 <strong>“深度思考”</strong> 过程的文本,在最终答案之前,展示出逐步的分析过程。你在使用时会看到它先输出一段思维草稿,再给出最终结论。这使得其推理过程更加透明、可信。 |
| <strong>“顿悟”式的强化学习训练</strong> | R1采用的训练方式不同于传统的“监督学习”+“人类反馈(RLHF)”。它更多依赖 <strong>纯强化学习</strong> 在探索中自我进化。在最关键的版本(R1-Zero)中,模型被奖励机制(如数学答案正确与否)驱动,在训练中 <strong>自发地</strong> 学会了延长思考时间、进行自我纠错等复杂的推理策略,这被研究者称为 <strong>“顿悟”时刻</strong>。 |
| <strong>高性价比与开源生态</strong> | 与售价昂贵、闭源的 o1 模型不同,DeepSeek-R1 是 <strong>开源</strong> 的(采用MIT许可证,允许商业使用和自由修改)。并且,其API <strong>调用价格远低于</strong> Open AI 的同类推理模型,大大降低了用户使用顶尖AI推理能力的门槛。 |
3. DeepSeek-R1 与 R1-Zero 的关系
这是理解R1系列的关键。
- DeepSeek-R1-Zero(极致的“野性”探索):
- DeepSeek-R1(优化后的“成品”):
4. 技术原理(通俗解释)
- 基础模型:R1基于DeepSeek自研的强大的基础大语言模型。
- 冷启动(SFT):在第一阶段,使用数千条高质量的“问题-思维链条-答案”作为示例,对模型进行微调,让模型模仿这种结构化的推理过程。
- 推理强化学习(GRPO算法):
- 拒绝采样与微调:在强化学习后期,模型会生成大量回答,团队会筛选出其中表现最好的样本,再次对模型进行微调,巩固其学到的能力。
- 全场景强化学习:最后,在包含推理、数学、代码、一般对话、写作等所有任务的数据集上进行最终的强化学习微调,确保其在提升推理能力的同时,不损害其通用能力和对话体验。
5. 优势与局限性
| 维度 | 优势 | 局限性 |
|---|
| <strong>能力</strong> | 在数学、代码、逻辑推理等领域达到了世界顶尖水平(基准测试与o1相当)。 | 在创意写作、情感对话等非推理类任务上,不一定比专门的通用模型(如GPT-4o)更出色,有时会显得过于刻板。 |
|---|---|---|
| <strong>成本</strong> | <strong>API调用价格极低</strong>,约为OpenAI同类模型的1/10到1/20,对开发者非常友好。 | - |
| <strong>开源</strong> | <strong>权重完全开源</strong>,允许任何人免费下载、研究、甚至在本地部署和商业化,极大地促进了AI社区的发展和应用创新。 | 本地部署顶级版本(671B参数)需要极高的硬件资源(多张A100/H100等),普通用户无法承受。 |
| <strong>使用体验</strong> | 推理过程透明,用户可以查看其思考步骤,便于信任和调试。 | <strong>响应速度较慢</strong>。因需要生成大量“思考”文本,输出第一个token的时间比普通对话模型长,且总输出token数更多,等待时间更长。 |
6. 与其他模型的对比
| 模型 | 推理能力 | 价格(API) | 可访问性 | 特点 |
|---|
| <strong>DeepSeek-R1</strong> | <strong>顶尖</strong>(与o1相当) | <strong>极低</strong> | <strong>开源</strong>(完全免费下载) | 性价比之王,专注推理,有显式思维链。 |
|---|---|---|---|---|
| <strong>OpenAI o1</strong> | <strong>顶尖</strong> | 高 | 闭源(仅通过API) | 推理能力强,但昂贵且不透明。 |
| <strong>GPT-4o</strong> | 强(但不如o1-类模型) | 中 | 闭源(API/网站) | 通用能力均衡,速度快,善于对话。 |
| <strong>Claude 3.5 Sonnet</strong> | 强(代码能力突出) | 中 | 闭源 | 在编程、长文本理解方面有独到优势。 |
| <strong>DeepSeek-V3</strong> | 较强(通用) | 低 | 开源 | R1的基础模型,是一个性能优秀的通用对话模型。 |
7. 总结与未来展望
DeepSeek-R1的成功不仅仅是发布了一个新模型,它的意义更加深远:
- 证明了“强化学习”是通往AGI的重要路径:它打破了“高质量人工数据是训练强大模型的唯一途径”的传统观念,证明了通过精心设计的强化学习框架,模型自身可以探索出更强大的能力。
- 极大地降低了顶尖AI推理技术的门槛:通过开源和低价API,它让全球的研究者、开发者和企业都能用上“o1级别”的推理能力,这必将催生出大量新的应用和研究成果。
- 推动了大模型领域的“军备竞赛”:它迫使其他巨头(如Google、Meta等)重新审视和加速自己的推理模型研发。
未来,我们可以期待:
- 推理模型将成为标配,融入更多应用(如高级数据分析、科研辅助、复杂自动化编程)。
- 推理成本会进一步降低,最终走向免费化。
- 将透明、可解释的“思维过程”与高效、迅速的“直觉响应”更好地结合。
总而言之,DeepSeek-R1 是一个里程碑式的作品。它在技术、成本和开源策略上“三管齐下”,不仅展示了中国AI模型的顶尖实力,更极大地推动了整个行业的前进。
如果你对它的具体技术报告,或是在特定领域(比如数学、写代码)的实际应用有什么想深入了解的,我们可以再继续讨论!
评论回复
0
暂无评论,快来抢沙发吧~